Autor
Luana Pereira
Data
outubro 8, 2026
Categoria
Governança
Uma agência roda agentes de IA entre vários clientes dando a cada cliente uma camada de dados isolada com permissão por cliente, para o dado de um nunca encostar no do outro, e transformando cada padrão aprendido numa regra que ela reusa entre clientes sem mover o dado de ninguém. Isolamento tem que ser um controle na camada de dados, não uma frase no prompt, e a verdadeira vantagem da agência, o padrão que ela aprende num cliente, deixa de morar na cabeça de um funcionário e vira um ativo versionado. Este guia cobre a unidade de isolamento, como montar o multi-tenant, e onde os agentes rodam por cliente.
Dando a cada cliente uma camada de dados isolada, definindo permissão por cliente, e fazendo os agentes operarem um cliente de cada vez, para o dado do cliente A nunca chegar num agente que trabalha no cliente B. A agência não constrói um agente onisciente que conhece quatorze APIs de todas as contas; ela constrói agentes que leem uma camada governada única e agem nas ferramentas-fonte, com acesso que é concedido, não presumido. Duas coisas fazem isso funcionar e nenhuma é instrução de prompt: isolamento aplicado na camada de dados, e o padrão que a agência aprende num cliente escrito como uma regra que ela reusa em outros sem mover o dado de ninguém.
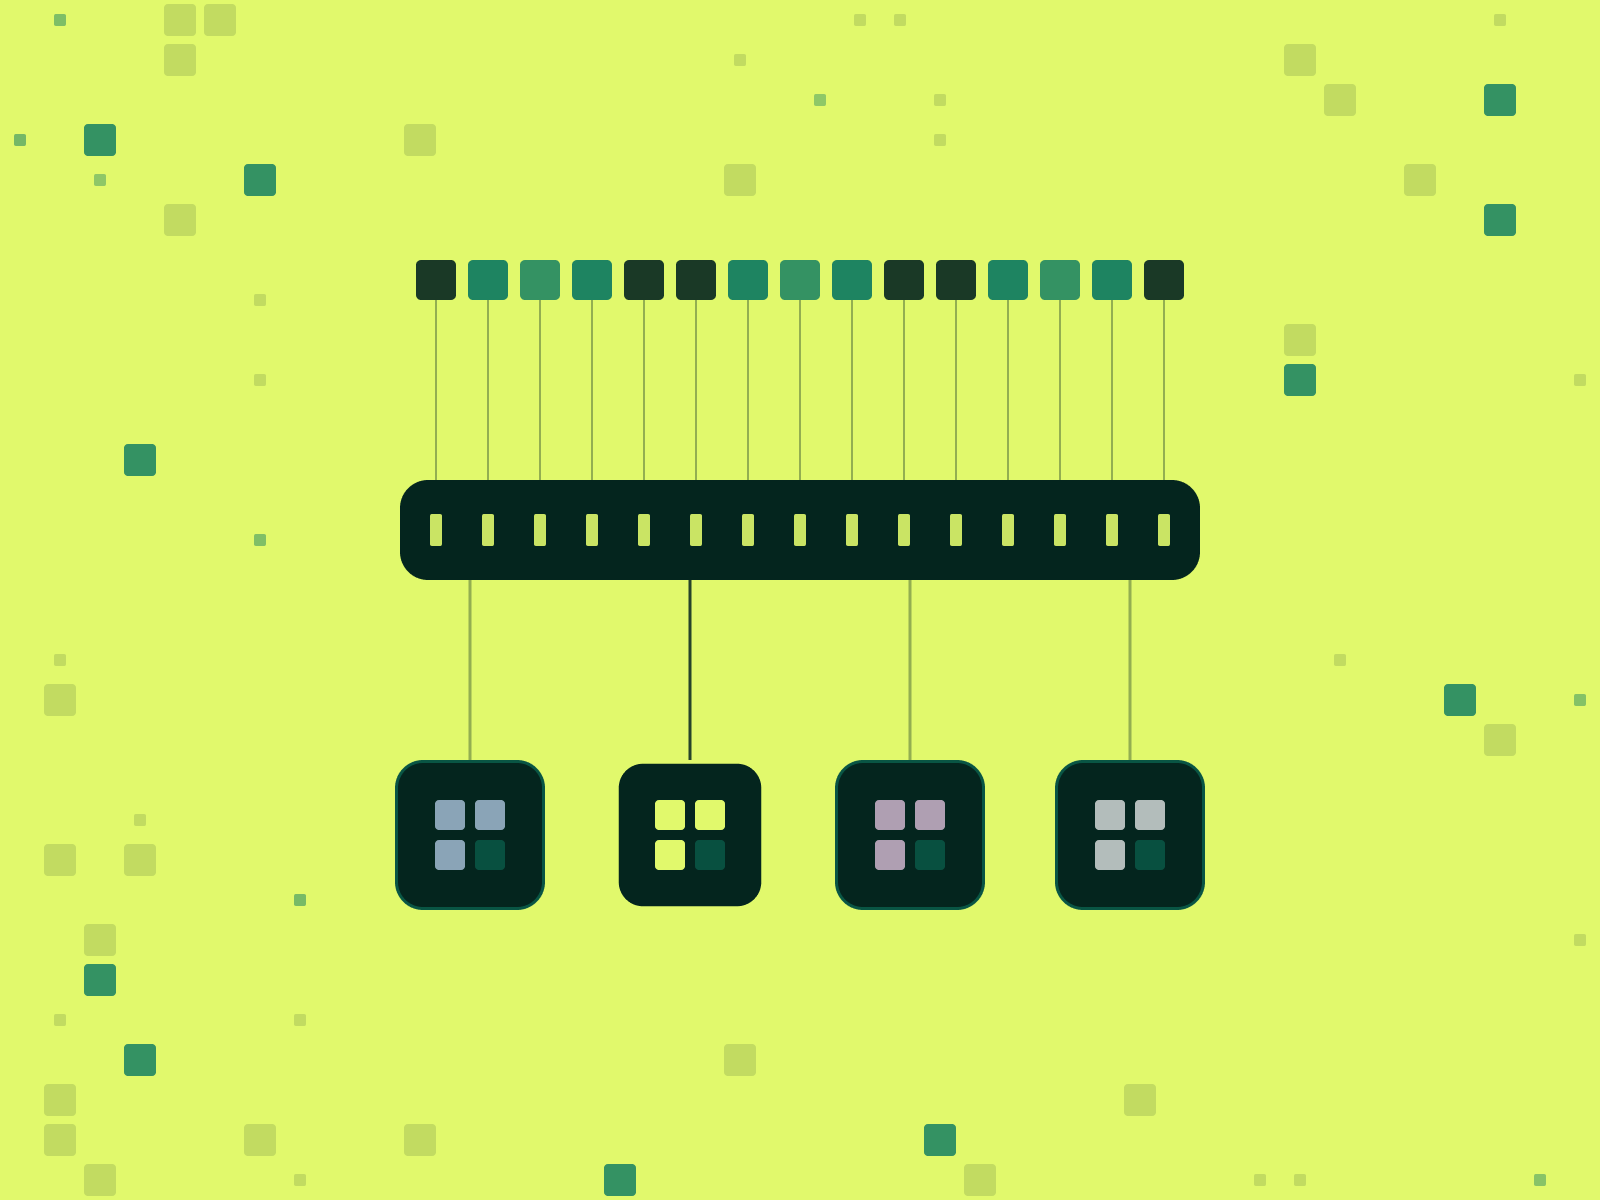
No catálogo, uma camada é a fronteira de armazenamento e permissão de topo. O token de acesso de um agente lê as camadas que lhe foram concedidas e não encosta numa camada que não foi. O isolamento vira um controle, não uma frase no prompt.
O setup comum de agência tem o dado morando numa dúzia de lugares: uma conta de anúncio aqui, um CRM ali, monitoramento de imprensa em outro canto, e quem quer cruzar dois deles abre quatro abas e uma planilha. Uma planilha não isola nada, não roda de madrugada, e ninguém consulta a planilha de outro cliente para achar um padrão. Rodar agentes em cima disso com segurança é exatamente o que uma camada de dados por cliente mais permissão por cliente resolve.
Porque o isolamento é o que o cliente de fato está pagando, e um vazamento entre clientes não é um bug, é quebra de contrato. A privacidade do dado do cliente é o produto. Então a regra de que o dado do cliente A nunca encosta no do cliente B não pode depender de um agente se comportar bem; ela tem que ser aplicada onde o agente não consegue burlar.
Essa é a diferença entre uma fronteira e um pedido. Se a única coisa que impede um agente de ler o dado de outro cliente é uma linha no prompt mandando não fazer isso, isso é um pedido educado, e um modelo sob pressão uma hora cruza, com confiança. Uma permissão definida na camada de dados é uma fronteira: o token do agente simplesmente não devolve as linhas de outro cliente, não importa o que o prompt diga. O modo de falha de depender do prompt, com um agente misturando dois clientes e afirmando o número misturado como fato, é a mesma classe de problema de por que agentes de IA dão respostas diferentes para o mesmo dado.
Há dois padrões documentados, e eles trocam manutenção por força. Os dois partem do mesmo inegociável: o cliente é uma dimensão de primeira classe, presente da camada Raw até a camada Service, nunca algo que você deduz depois a partir do nome de uma campanha.
Em volta de qualquer um dos padrões, três coisas são configuradas por cliente. As fontes são conectadas por cliente, e um setup link pode convidar o cliente a preencher as próprias credenciais de fonte, para a agência nunca mexer nelas. As permissões são atribuídas com papéis e grupos, no nível de camada, pasta, tabela e volume, para o acesso ser no nível do dado em vez de no fio do bigode. E o agente alcança o dado por um servidor MCP com um token de acesso cujo escopo é exatamente as permissões de plataforma que lhe foram concedidas, que é o que torna o agente de um cliente fisicamente incapaz de ler o de outro.
| O que | Por cliente, isolado | Compartilhado entre clientes |
|---|---|---|
| Dado e tabelas | O dado de cada cliente, filtrado por cliente ou na própria camada | Nada |
| Fontes e permissões | Conectores e acesso escopados àquele cliente | Nada |
| Token de acesso do agente | Lê só as camadas concedidas | Nada |
| Regras aprendidas | Aplicadas ao próprio dado de cada cliente | O padrão, como regra escrita, não o dado |
Escrevendo o padrão como uma regra em vez de deixá-lo na cabeça de alguém. A verdadeira vantagem de uma agência nunca foi a mão de obra; é a largura, ter visto o que funciona em muitas contas que um time interno sozinho nunca toca. O problema é que essa largura costuma morar na memória dos analistas, é redescoberta toda vez que uma conta nova roda o mesmo teste, e vai embora pela porta quando uma pessoa sai. A agência mantém o logo e o contrato e perde a expertise, que nunca esteve escrita em lugar nenhum.
Uma regra escrita muda isso. Quando um agente aprende algo numa conta, o padrão vira um context document na camada semântica: regras de negócio em linguagem comum, anotadas às tabelas e colunas concretas a que se referem, guardadas e versionadas, lidas pelo agente antes de ele agir. Uma definição como o que conta como cliente ativo, ou a observação de que um ângulo rende mais que outro para um tipo de conta, persiste porque schemas mudam mas definições não. A parte importante para uma agência é que a regra é portátil enquanto o dado não é: o mesmo padrão escrito pode informar o agente que trabalha em outro cliente, aplicado à camada isolada daquele cliente, sem uma única linha cruzar entre contas. O que antes dependia de um analista lembrar de avisar o time vira um ativo que a agência possui. Anexar esse significado ao próprio dado é context engineering para agentes de IA, e as definições governadas que ele produz são uma camada semântica para agentes de IA.
Cada agente consulta a camada de um cliente e age nas ferramentas daquele cliente. A separação é a mesma que deixa um time pequeno rodar muitos agentes sem caos: a leitura acontece num lugar só, a camada governada, e a ação acontece na ferramenta-fonte, que continua a fonte da verdade do que ela possui. O CRM continua a fonte da verdade do lead, a plataforma de anúncio da campanha; o agente chama a API daquela ferramenta direto na hora de executar, e consulta a camada quando precisa saber algo.
Para uma agência isso mantém cada agente simples e seguro. Um agente conhece uma fonte de leitura, a camada do seu cliente, e poucas ferramentas de execução, em vez de virar um sistema onisciente que precisa entender toda API de toda conta. O custo de tokens fica baixo, porque uma consulta determinística contra a camada é muito mais barata que paginar a API de uma ferramenta repetidamente, e o escopo fica apertado, porque o token de acesso do agente está preso a um cliente. É a mesma arquitetura de um stack de GTM AI-native, agora desenhada por tenant, e operar um agente de mídia paga assim, consultando o desempenho na camada e agindo nas plataformas de anúncio, é abordado em como operar mídia paga com um agente de IA.
A Nekt é uma plataforma de contexto para agentes de IA. Ela conecta seus sistemas, guarda seus dados e o histórico deles em um único data warehouse governado, registra o que cada número significa e entrega tudo para o Claude, o ChatGPT ou qualquer agente por um único MCP governado. Multi-tenant é um exemplo direto das três partes que ela cobre, aplicadas por cliente.
O resultado é que a largura da agência deixa de ser frágil. Ela aprende com muitos clientes ao mesmo tempo, mantém o dado de cada um isolado por um controle de verdade, e guarda o aprendizado como um ativo escrito em vez de na memória de quem pode sair. Veja como a Nekt funciona, ou crie uma conta gratuita e conecte sua primeira fonte.
Com permissão na camada de dados, não com instrução no prompt. Cada cliente tem uma camada isolada (ou uma coluna de cliente filtrada em toda consulta), e cada agente conecta por servidor MCP com um token que só enxerga o dado daquele cliente, então o agente do cliente A não lê o cliente B. O playbook pode ser reaproveitado entre clientes, porque o que se reusa é a regra, não o dado.
Sim. Ou mantenha um modelo com o cliente como coluna de primeira classe e filtre toda query por cliente, ou dê a cada cliente a própria camada, que é a fronteira de permissão de topo. Nos dois casos o acesso do agente é escopado para ele ler um cliente de cada vez, e a camada semântica diz a regra de que toda query é por cliente, para o modelo não misturar contas.
Com uma permissão na camada de dados, não uma linha no prompt. O controle de acesso é definido por camada, pasta, tabela e volume, e o agente alcança o dado por um servidor MCP com um token escopado exatamente a essas permissões. Um agente que recebeu a camada de um cliente não devolve as linhas de outro, não importa o que peçam, porque a fronteira é aplicada abaixo do modelo.
Dá, porque o que você reusa é a regra, não o dado. Um padrão aprendido numa conta é escrito como um context document na camada semântica, versionado e anotado ao dado que descreve. Essa regra pode informar o agente que trabalha em outro cliente, aplicada à camada isolada daquele cliente, sem nenhuma linha cruzar entre contas. O aprendizado é compartilhado; o dado fica separado.